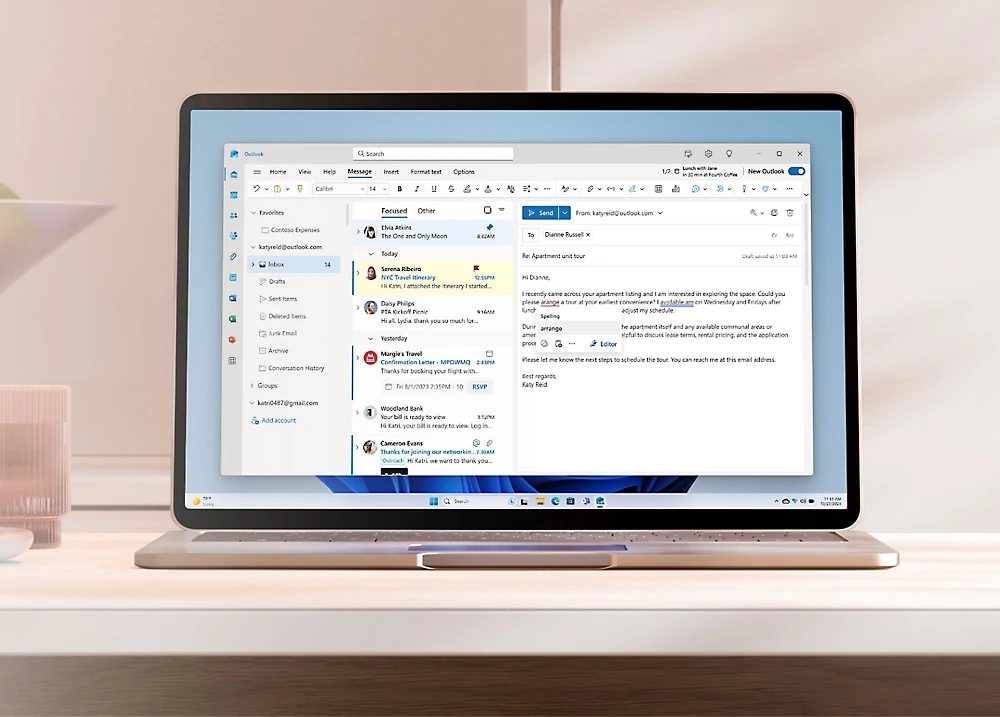
Los servicios de Microsoft comenzaron a recuperar su funcionamiento después de una interrupción global que afectó durante más de 18 horas a millones de usuarios y organizaciones. La falla impactó principalmente a Outlook y Microsoft 365, aunque también provocó problemas en otras herramientas de la compañía, como Teams, SharePoint y Copilot.
La interrupción comenzó el jueves 12 de noviembre y se extendió hasta el viernes 13. Durante ese periodo, numerosos usuarios reportaron dificultades para acceder a sus correos electrónicos, abrir sus buzones y utilizar distintas funciones de las aplicaciones de Microsoft. En algunos casos, los mensajes tampoco llegaban a sus destinatarios o quedaban pendientes de entrega.
Microsoft identificó problemas en la infraestructura de Exchange Online, el servicio que gestiona el correo electrónico de Microsoft 365. De acuerdo con las actualizaciones de la compañía, algunos procesos centrales de los servidores se saturaron y dejaron de responder, lo que redujo la capacidad de la infraestructura y afectó a otros servicios conectados.
Para solucionar el incidente, la empresa implementó medidas de administración del tráfico, reinició servidores afectados y aplicó cambios en componentes relacionados con la autenticación y el enrutamiento de las conexiones. También comenzó a recuperar gradualmente parte de la infraestructura y a extender las acciones correctivas a otras regiones.
La recuperación avanzó por etapas. Microsoft reportó mejoras en distintas zonas de Asia-Pacífico, Europa y Norteamérica, aunque advirtió que la disponibilidad todavía podía variar entre usuarios. Por ello, algunas personas podían recuperar el acceso mientras otras continuaban experimentando interrupciones intermitentes o retrasos en la recepción de correos.
Además de Outlook, la incidencia alcanzó funciones de Teams relacionadas con calendarios y reuniones, así como herramientas de SharePoint, Microsoft Copilot, Planner, To Do y otros servicios empresariales. El impacto evidenció hasta qué punto las actividades laborales y operativas dependen de una misma infraestructura digital.
La compañía señaló que no tenía indicios de que el incidente estuviera relacionado con una actividad maliciosa o un ciberataque. También indicó que sus equipos continuarían revisando lo ocurrido para identificar las causas y prevenir fallas similares.
Aunque el regreso gradual de los servicios representa un avance, la normalización no fue inmediata para todos los usuarios. El incidente vuelve a poner sobre la mesa la importancia de contar con sistemas alternativos de comunicación, respaldos de información y planes de continuidad para empresas y organizaciones que dependen de plataformas en la nube.